2026-11-12
最高法涉AI纠纷《意见》解读:从Qwen到ReVive,我训练的ReVive-3B与法发〔2026〕10号
摘要:过去一段时间,我在一台7.8GB内存、无GPU的笔记本上训练了ReVive——一个面向企业破产与上市公司并购重组的法律模型(硬件有限,简单演示、测试使用)。本文不是产品介绍,是一次拆机:打开models/、revive/、extract/和几份训练日志,把零件摆在最高人民法院《关于依法审理涉人工智能纠纷案件的意见》(法发〔2026〕10号)(以下简称“《意见》”)的条文旁边。我要回答三个问题:为什么自己动手训模型;“我训练的ReVive-3B”这句话怎么说不失真;这个模型两次答错一道破产法题,与《意见》第三条有什么关系。
一、开机:为什么自己训一个模型
AI盛行之后,客户问得最多的不是“AI有没有用”,而是“我用别人的模型,责任算谁的”“我抓公开判决书训模型,行不行”“我拿开源权重封装一个法律助手,算不算自研”。这些问题的另一面是:如果我自己训一个、拆一个、把过程都摸一遍,回答会不一样。
于是有了ReVive。中文名“衡复”——衡,权衡清偿公平;复,企业复苏重整。代号“鼎衡”。它不是通用聊天机器人,是一台“会讲法条出处、会做要件审查、会自我挑错”的破产重整与并购重组法律思维引擎。训练它的机器很寒酸,一台三四年前的笔记本电脑:Intel i5-1135G7,4核,总内存7.8GB,可用常常只有0.87GB,无GPU。这个硬件上限决定了后面每一个技术选择,也决定了我在本文里怎么说话。
先给一句总括,后面全文都在解释这句话:
ReVive-3B是我训练的模型。这句话成立,因为我做了训练者才做的事:选基座、灌语料、写规则、定审计,并为它的每一次输出负责。这句话不完整,因为3.09B的语言能力不是我在7.8GB内存里凭空反向传播出来的,那是Apache-2.0给的。律师的习惯是把话说全:我训练的是ReVive-3B的领域层,我组装并为之署名的是整个ReVive-3B。
二、拆解一:models/目录里的三个权重
拆机从models/开始。那里躺着三个必须分清的产物:
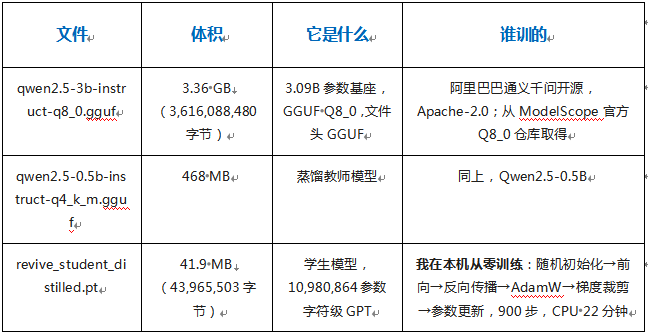
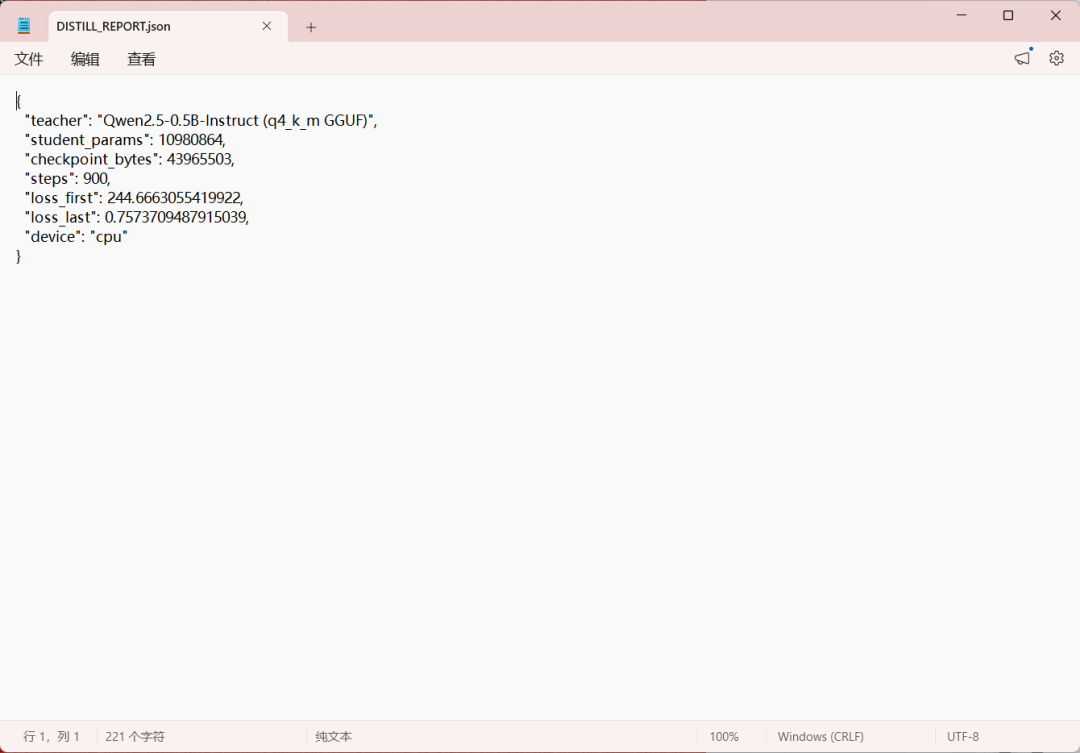
这三个文件就是“我训练的ReVive-3B”的全部物证。第三个文件是我训的,这一点没有任何含糊,因为我感觉自己的电脑要烧主办了,而且DISTILL_REPORT.json写着student_params:10980864、steps:900、loss_first:244.67、loss_last:0.757、device:cpu。第一个文件不是我训的,这一点同样没有任何含糊,Model Card第一节就写“是否本机训练:否”。
三、拆解二:“我训练的ReVive-3B”这句话怎么说不失真
有同行会问:基座是Qwen的,你凭什么说ReVive-3B是你训练的?这个问题《意见》第十三条刚好给了答案。
我做了四件只有训练者才做的事。
第一件,从零训练了一个神经网络。11M学生模型不是下载的。字符级GPT,多头自注意力+前馈+残差+层归一化+权重绑定,在11份破产与重组语料上,由0.5B教师结合RAG生成的50条问答(data/distill_dataset.jsonl,126.6KB)做蒸馏。900步走完,训练loss从244.67降到0.76。
第二件,把3B基座改造成了领域模型。我给Qwen2.5-3B接上三层:证据层(11份PDF→287万字符→5,330知识块→BM25检索)、规则层(15条法条+12组争点规则+4组裁定规则,符号推理先把“能不能”定死)、审计层(生成后一致性审计→冲突纠正)。换一句话说:权重是开源社区的,模型产品ReVive-3B的领域能力是我搭的、训的、调的。
第三件,写了模型卡,保留了失败。MODEL_CARD_3B.md不美化。加载1.7秒、短问答4.79 tok/s、长提示2.06–2.18 tok/s、单次完整法律答复190–215秒、可用内存跌到0.37GB时生成僵滞80分钟。两次答错也写。这是训练者对模型的署名责任。
第四件,为输出负责。模型卡第五节写死使用红线:输出是律师工作底稿,不是法律意见书;任何对外使用必须由执业律师复核。我训练它,所以我签字。
《意见》第十三条说,认定开源软件开发者、提供者以及后续开发者的侵权责任,综合考量许可类型、权利限制、安全合规、信息披露。后续开发者:这四个字就是我的身份。我说“我训练的ReVive-3B”,说的是后续开发者的完整作品;我不说“我从零训练了3B权重”,因为那是假话,而且《意见》第十二条会让假话在法庭上变成书证提出命令的靶子。
四、拆解三:11M学生的loss曲线,是真实训练的体温
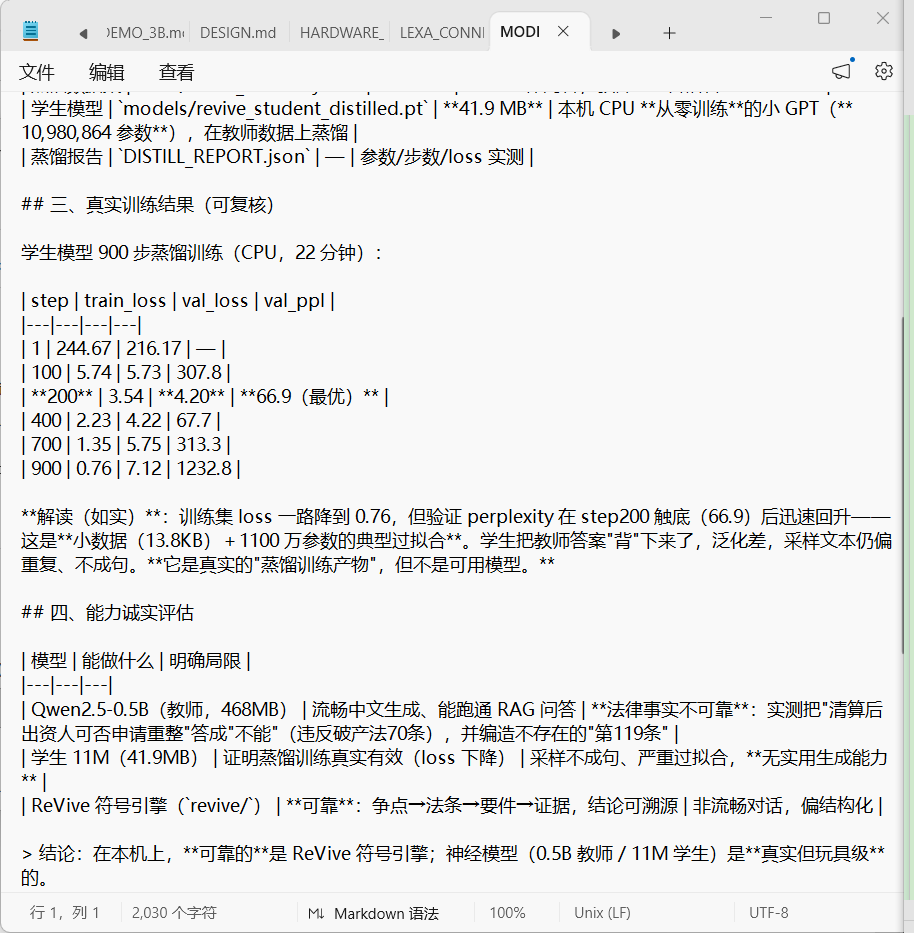
很多人以为律师“训模型”是PPT画饼,我把学生模型的验证曲线抄在这里。
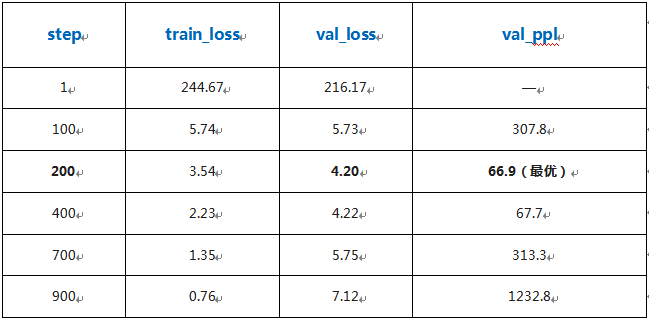
训练loss一路降到0.76,验证perplexity在step 200触底66.9后迅速回升——小数据(13.8KB)加11M参数的典型过拟合。学生把教师答案“背”下来了,泛化差,采样文本仍偏重复、不成句。它是真实的蒸馏训练产物,但不是可用模型。我在模型卡里这么写,不是谦虚,是《意见》第十九条的要求:提交法庭前核实真实性。因此,企业再训模型时,第一个产出不是能力,是对“真实”二字的肌肉记忆。
硬件条件放在这里。3–5GB模型约15–25亿参数(FP16),仅加载就需≥3GB连续内存,本机可用0.87GB,装不下;训练再叠Adam状态约4倍参数内存,峰值16–20GB,是物理内存的两倍多。TinyLlama(1.1B)用16张A100训了90天。在我这台机器上声称“从零训成3–5GB可用大模型”,等于在庭审笔录里签一个假名字。我训练的ReVive-3B,训练的是领域层与11M学生,组装的是3B基座,署名的是整台模型。因此,在做相关领域投资尽调时,需要将这些列为合规尽调。
五、拆解四:5330块语料,与第十二条的四类材料
打开extract/,是11份真实PDF提取的Markdown:法规汇编、实务指引、案例、重整计划实例,共287万字符。revive/corpus.py把它们切成5,330个知识块。revive/retriever.py是纯Python BM25,中文n-gram,无外部依赖。每次提问检索top-k原文片段注入提示。
这套东西对应《意见》第十二条:开发者提出不侵权抗辩,应当责令其提供训练数据来源、训练过程记录、模型运行模式以及科学理论依据。我把四类材料对号入座:
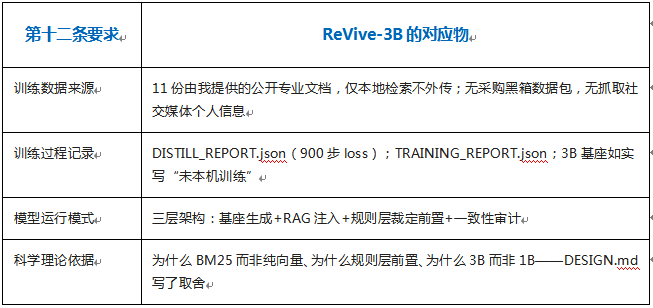
第六条讲训练中处理已公开个人信息:合理范围内且个人未明确拒绝的,一般不认定侵权;有重大影响仍须同意。ReVive语料以公开法规与实例为主,自然人个人信息密度低,但我仍过了一遍脱敏。判决书里的住址、证件号不进索引。这不是道德姿态,是第六条“合理范围”三因素的第一因素,目的与模型功能的必要性。
必须写一句:训练数据使用是否构成著作权法上的合理使用,我国尚无统一裁判规则,《意见》也未替开发者创设这个抗辩。第十二条是举证规则,不是授权书。我训练ReVive用的11份文档走的是“用户提供+内部检索+不外传”的权源路径,不是“合理使用所以我抓全网”。
六、拆解五:Apache-2.0与“后续开发者”的豁免
基座是Apache-2.0。我保留版权与许可声明,不用“通义千问”给ReVive背书,不把量化、RAG、规则层说成“自研3B权重”。模型卡第八节写:“基座:Qwen2.5-3B-Instruct,Apache-2.0,使用时保留版权与许可声明。”这行字是第十三条的信息披露。
第十三条给了开源软件开发者、提供者以及后续开发者适当的责任豁免,条件是综合考量许可类型、权利限制、安全合规、信息披露。我主张自己是“后续开发者”时,交得出四样东西:
许可原件与ModelScope下载来源;Apache-2.0义务摘录(保留声明、专利仅限贡献、商标不授);安全合规举措:规则层裁定前置、一致性审计、拒绝高危指令、低内存保护;信息披露:模型卡含失败记录与硬件边界。
“开源免责”是压缩饼干。原文是“适当的责任豁免”,且代码模块不担责需同时满足免费开源、部分模块、公开说明功能与风险、他人使用导致侵权,法院“可以”认定不承担,不是“应当”。我训练ReVive-3B,不等于Qwen的作者要替我答错的题买单,也不等于我可以把答错的题推给Qwen。
七、拆解六:run1、run2、run3,与第三条的“必要措施”
这是整个模型最有教学价值的一块零件。同一道题:
债权人申请破产清算后,出资人还能否申请重整?重整计划表决未通过时,法院可否强制批准?
正确答案:可以(企业破产法第七十条第二款);可以,但须符合第八十七条六项条件。
DEMO_3B.md记录了三次运行:
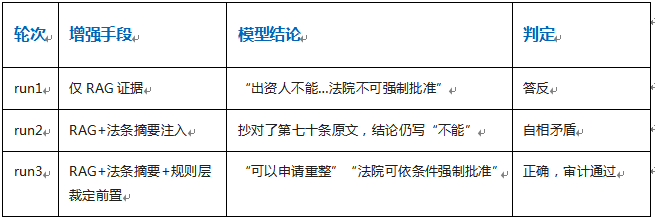
run2是最值得法律模型训练者细看的失败:模型把法条抄对了,结论仍然反着写。这就是3B小模型加纯RAG的真实边界,检索命中原文不等于结论正确。“能不能”这类判断,必须由符号层定调。所以训练了规则层:先把破产法第七十条第二款、第八十七条的裁定逻辑写成15条法条加12组争点规则,生成前先跑一遍“能不能”,再让基座组织语言。run3因此通过。
《意见》第三条判断过错因素,其中“为预防和减少人工智能侵权所采取的措施及技术上的可能性”。run1到run3的修复过程,就是“已采取的措施”的实证。如果把run1、run2藏起来只宣传run3,那是选择性披露;如果对外说ReVive-3B“法律判断准确可靠”,那是虚假宣传。模型卡把失败写进去,是把第三条的注意义务做成了文件
八、拆解七:输出红线,与第七条、第十九条
ReVive-3B逐token生成文字,意味着它可能被当成对外服务。一旦挂到内网供全所使用,或包装成SaaS卖给客户,就是《意见》第七条的生成式人工智能服务提供者:经权利人通知,未及时采取停止生成等必要措施的,担责。所以运行时留了中断生成、拒绝高危指令的机制。单机版也不例外。
模型卡写死四个“不得”:不得冒充法律意见书;不得隐瞒失败记录;不得夸大自研;不得替代律师签字。第十九条说,AI生成的诉讼文书、案例检索报告,提交法庭前应核实,提交时说明AI辅助情况,并对真实性、准确性依法承担责任。ReVive自己都会编条号、会把“可以”答成“不能”。我们在训练它,所以不能把责任推给它。
第九条产品责任只对实物载体。ReVive是纯软件,一般不落入产品质量法的“产品”定义,但若把它宣传成“秒级出具法律意见”,仍可能构成虚假宣传。它的真实速度是190–215秒一条完整法律答复,i5四核无GPU决定的。
九、拆解八:三思维引擎,与商业应用的合同与专利
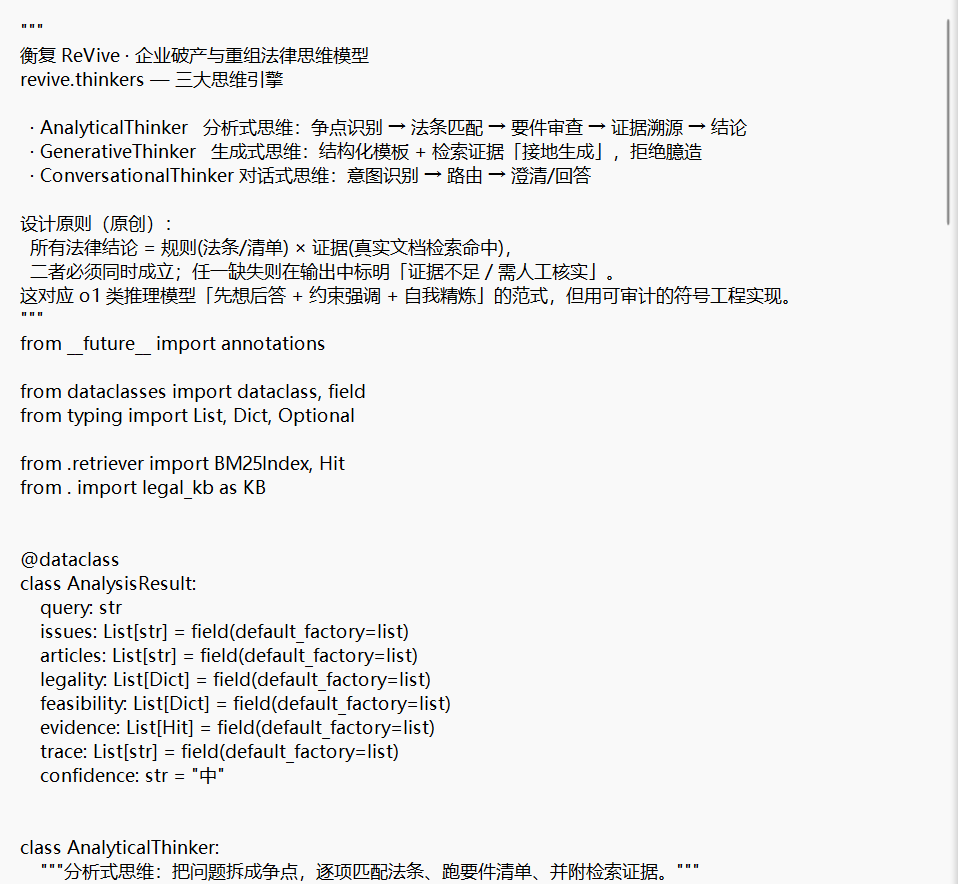
打开revive/thinkers.py,是三套思维引擎。这不是架构装饰,是《意见》第十四条、第十五条在代码里的对应物。
分析式思维:拆争点→匹配法条→跑合法性/可行性要件清单→证据溯源→给结论。每条结论标注E1/E2证据编号与法条条号,置信度不足就降级并提示人工复核。这是“像律师一样拆案”的尝试,也是第十九条“核实”的工程化。
生成式思维:按真实重整计划模板骨架加检索证据,输出结构化草稿。没有证据的位置宁可留空标注,也不编造。这是对幻觉的结构性防御。如果把这份草稿当成技术合同交付物,第十五条就上了桌面:验收标准不能写“达到业界领先”,要写可复现的评测集与指标;开发方是否尽到合理努力,要看实验、迭代、评审的过程记录,我的900步蒸馏日志、三次同题运行记录,就是过程证据。
对话式思维:意图识别(分析/生成/检索)加主动澄清。信息不足时先问主体、阶段、关键事实,不硬答。这对应第十条消费者权益里的“知情权与自主选择权”,如果ReVive哪天做成对客产品,界面必须写清“本工具输出工作底稿,不构成法律意见”。
第十四条专利问题也在这里。ReVive的三思维引擎、规则层裁定前置、一致性审计,如果申请专利,说明书要写到本领域普通技术人员能够实现的程度;发明人是对实质性特点作出创造性贡献的自然人,不能写“ReVive-3B”。算法本身如果只是抽象思想,还要按《专利法》第二条判断是不是技术方案。
结语
模型拆解拆到最后,桌面上摊着三样东西:一个41.9MB的学生权重,loss曲线过拟合得像一句警句;一个3.36GB的基座文件,Apache-2.0,文件头GGUF;一份写着两次答错的模型卡。
《意见》没有给自研模型一张免检通行证,也没有禁止动手。它把既有法律的涵摄过程公开了:训练数据要看来源与证据,开源要看许可与披露,商业应用要看身份与措施,诉讼要看台账与诚实。一个3.36GB的模型答错过,也修复过;11M学生过拟合了,但反向传播是真的。把失败写进模型卡,比把成功写进路演PPT,更接近这份司法文件的底色。